
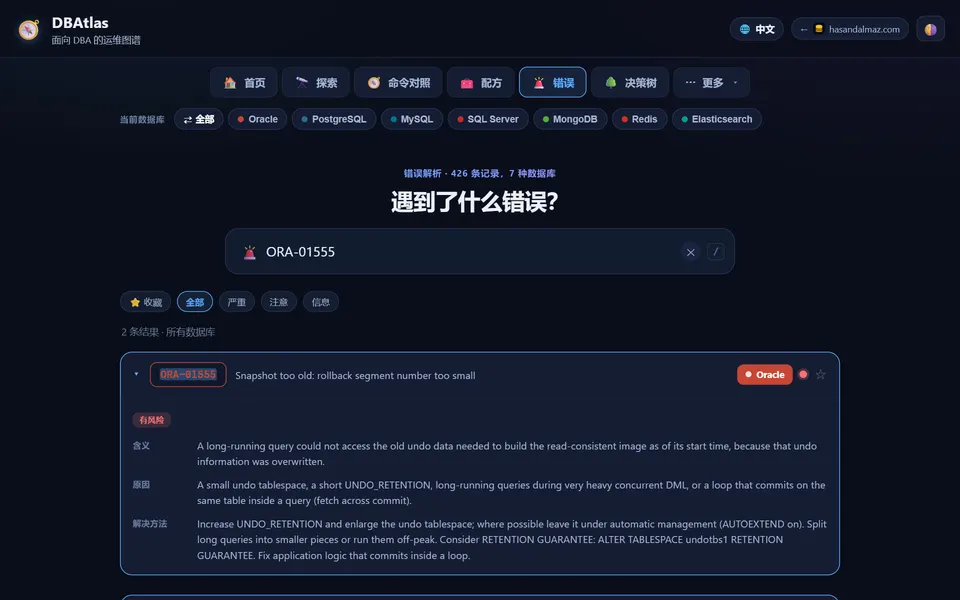
DBAtlas — 面向 DBA 的运维图谱
7 种数据库的命令对照、错误解决方案、决策树和分步应急手册 — DBA 处理故障时所需的一切,集中在一处。
- 命令
- 1,480+
- 命令
- 错误解决方案
- 426
- 错误解决方案
- 决策树
- 40
- 决策树
- 数据库
- 7
- 数据库
打开图谱
今天已有 位 DBA 使用
数据库控制台
数据库世界速览
将鼠标悬停在数据库或概念上 — 查看其关键区别、优势、注意事项和适用场景。
数据库
概念
› SELECT inst_id, instance_name, status FROM gv$instance ORDER BY inst_id;
- ▸ 关键区别
- 借助 RAC,多台服务器共同运行同一个数据库;其中一台故障时,系统仍保持运行。
- ✓ 优势
- 在不间断运行和灾难恢复(Data Guard)方面最成熟的企业级选择。
- ⚠ 局限
- 许可费用高,对专业能力要求高;用于小型项目大材小用。
- → 适用场景
- 不能容忍停机的大型企业系统:银行、ERP。
› CREATE EXTENSION vector;
- ▸ 关键区别
- 开源;可通过扩展增强功能 — 例如地图数据或用于 AI 的向量搜索。
- ✓ 优势
- 免费、强大且遵循标准;从简单记录到复杂查询都能胜任。
- ⚠ 局限
- 更新/删除频繁的系统需要定期进行 VACUUM 维护和调优。
- → 适用场景
- Web 和移动应用后端、地图(GIS)和 AI 项目。
› CREATE AVAILABILITY GROUP ag_prod;
- ▸ 关键区别
- Microsoft 的数据库;与 Windows/.NET 生态无缝协作,并提供强大的工具(SSMS)。
- ✓ 优势
- 在同一系统中兼顾日常事务处理与报表/分析。
- ⚠ 局限
- 在 Windows 上运行效果最佳;企业版许可费用昂贵。
- → 适用场景
- 企业级 .NET 应用和商业智能/报表系统。
› START REPLICA;
- ▸ 关键区别
- Web 上最流行的数据库;易于安装和使用,社区庞大。
- ✓ 优势
- 轻量且快速;易于扩展,尤其适合读多写少的网站。
- ⚠ 局限
- 在非常复杂的分析和高级查询方面不如 Oracle/PostgreSQL 深入。
- → 适用场景
- WordPress 等网站以及高流量、读多写少的 Web 应用。
› db.orders.find({ status: "paid" })
- ▸ 关键区别
- 以灵活的“文档”(类似 JSON)而非表的形式存储数据;无需固定模式。
- ✓ 优势
- 开发速度快,适合大量且频繁变化的数据,易于横向扩展(分片)。
- ⚠ 局限
- 设计不当会导致数据重复和不一致;在需要严格关系完整性的场景下并非首选。
- → 适用场景
- 商品目录、内容管理以及结构频繁变化的应用。
› SET session:42 online EX 3600
- ▸ 关键区别
- 将数据保存在内存(RAM)而非磁盘中,因此几乎可以即时响应。
- ✓ 优势
- 速度极快;非常适合缓存、会话和实时计数器。
- ⚠ 局限
- 数据必须能放入内存,且持久化必须配置正确,否则可能丢失数据。
- → 适用场景
- 缓存、会话存储、排行榜以及所有对速度要求高的场景。
› GET /products/_search?q=laptop
- ▸ 关键区别
- 专为文本搜索打造的引擎;通过倒排索引检索数百万文档,并按相关性排序结果。
- ✓ 优势
- 极快的搜索、自动补全和日志/分析(ELK stack);易于横向扩展。
- ⚠ 局限
- 不是主数据库;通常作为搜索/日志层与主数据库配合运行。
- → 适用场景
- 站内与商品搜索、日志分析和可观测性。
› SELECT * FROM orders JOIN users USING (id);
- ▸ 关键区别
- 将数据整齐地存储在相互关联的表中,并用 SQL 查询;这一模型已经过数十年验证。
- ✓ 优势
- 强一致性:事务要么完全执行,要么完全不执行(ACID)。处理复杂查询能力非常强。
- ⚠ 局限
- 难以分布到多台机器(分片);后期修改表结构需要周密规划。
- → 适用场景
- 资金、库存以及任何对正确性要求极高的系统。
› { "user": "hd", "roles": ["dba"] }
- ▸ 关键区别
- 使用灵活的结构(文档、键值…)代替固定的表;为大规模而设计。
- ✓ 优势
- 易于分布到多台机器,可轻松应对高写入负载。
- ⚠ 局限
- 通常缺少 SQL 的强一致性保证和表连接(JOIN)。
- → 适用场景
- 大规模 Web、实时分析和结构灵活的数据。
› BEGIN; UPDATE acct SET bal = bal - 100; COMMIT;
- ▸ 关键区别
- 两种一致性理念:ACID 保证每个事务完整完成;BASE 为了速度和可用性放宽这一要求。
- ✓ 优势
- ACID 为资金等关键数据提供可靠保证;BASE 支持超大规模和持续可用。
- ⚠ 局限
- 在 BASE 下,数据可能短暂“过时”;应用需要考虑这一点。
- → 适用场景
- ACID:支付系统。BASE:社交媒体信息流、点赞计数。
› -- OLTP: point writes · OLAP: aggregate scans
- ▸ 关键区别
- 两类工作负载:OLTP 是大量日常小事务(订单、支付);OLAP 是面向海量数据的分析。
- ✓ 优势
- 合理拆分可让两者都更快:一个处理日常业务,另一个负责报表。
- ⚠ 局限
- 在同一系统上同时运行两者会相互拖慢,因此通常分开部署。
- → 适用场景
- OLTP:订单/支付。OLAP:报表、仪表板和数据仓库。
联系
有问题?请留言。